算力有限时,企业 AI 该先追求质量还是覆盖面?聊聊模型路由这笔账
企业 AI 推广初期,同样的算力可以让少数人用最好的模型,也可以让更多人先用起来。我倾向于后者:把模型路由当成算力预算管理,追求的不是单次质量最高,而是整体价值面积最大。
最近做企业智能体项目,碰到一个挺现实的矛盾。
一边有同事说,AI 既然要上,效果就要做到最好,第一次使用体验很重要——用户试两次觉得不好用,以后就不用了。
另一边的问题是:现有这批 GPU 只够支撑有限并发。如果所有请求都走最强的那个大模型,几十 K 甚至上百 K 上下文的 Agent 场景下,一个实例能稳定服务多少人,其实比想象中少得多。模型效果很好,但绝大多数人根本没机会稳定用上。
这两种想法都对,只是关注的对象不一样:一个盯着单次质量,一个盯着覆盖面。
最近我对这个问题的判断逐渐明确了一些。在企业 AI 刚开始规模化推广的阶段,我倾向于后者:
先让足够多的人真正用起来,再逐步让他们用得更好。
这也是我现在理解模型路由价值的一个重要角度——它解决的不只是「哪个模型效果最好」,而是企业手里有限的一份算力,到底怎么分配,才能产生最大的实际价值。
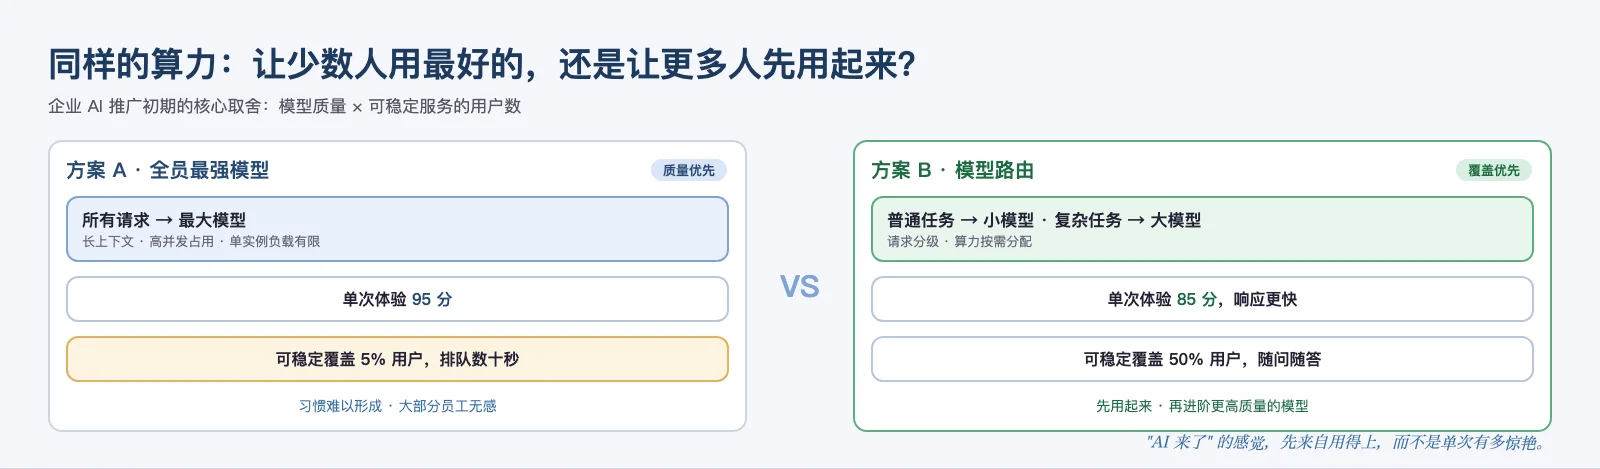
图 1 · 同样的算力:让少数人用最好的,还是让更多人先用起来?
一、最好的模型,不一定带来最好的推广效果
假设企业有两种选择。
方案 A:所有用户全部走最强的大模型。文档写得更好,复杂分析更强,长上下文表现也最稳定。但因为模型重、上下文长、单请求占资源多,整套系统只能承载 100 个并发。
方案 B:大部分普通任务先交给小一点的模型,真正复杂的任务再切到大模型。单个任务的平均效果可能降一点,但整套系统可以承载 300、500 甚至更多并发。
从纯模型评测角度看,选 A。Benchmark 谁分高就谁上。
但到了面向几千、几万员工的企业内部应用里,这个问题就没那么简单了。
企业最终购买的,其实不是模型 Benchmark 上的分数,而是:有多少员工能够稳定使用 AI 完成工作。如果一个 95 分的模型只能让 5% 的人稳定使用,一个 85 分的模型能覆盖 50%,很难直接说前者业务价值一定更高。
尤其是在企业 AI 推广初期。这个阶段最缺的,很多时候还不是那 10 分的模型能力,而是使用习惯。
二、我真正在意的一个指标:一个员工一天会不会主动打开 AI
讨论企业 AI,注意力很容易都放在模型上——哪个推理能力强、哪个写材料效果好、哪个长上下文更稳。这些当然重要。
但把视角拉到「企业内部真正推广 AI 这件事」上,我觉得还有一个指标非常关键:
一个员工一天会不会主动打开 AI。
这个习惯一旦建立,后面很多事情才有意义。写一个通知的时候先让 AI 整理一下;看到一份长材料,让 AI 先做摘要;准备会议时让 AI 帮忙列提纲;Excel 里碰到公式不会写,先问一下 AI;写 SQL、写脚本、查制度、做 PPT 的时候,自然想到旁边还有一个 AI 助手。
这些场景单独看都不复杂,甚至不需要最强的大模型。但它们出现得足够频繁以后,用户会逐渐形成一种新的工作方式:我先看看 AI 能不能帮我做一点。
如果员工一个星期只有一次机会用 AI,而且每次还要排队几十秒,再好的模型也很难形成习惯。反过来,简单任务随时能问、响应足够快、结果基本可用,AI 反而更容易进入日常工作流。
从这个角度看,并发能力本身就是 AI 体验的一部分。
三、模型能力其实可以按任务分层
这是模型路由最适合发挥作用的地方。
企业办公智能体里的任务差别非常大。有些任务确实需要强模型:复杂报告生成、跨文档分析、长材料归纳、复杂推理、代码分析、多步骤 Agent 任务。
但还有大量请求并没有这么高的要求:改一下措辞、总结一段会议记录、提取几个关键信息、写一段通知、把一段话整理得更正式、查询一个制度条款、生成一个简单 SQL、翻译一段文字。
如果这些请求也全部送到几十 B 甚至上百 B 参数的大模型上,本质上有点像每天开一辆重型卡车去楼下取快递。当然可以,就是成本有点高。
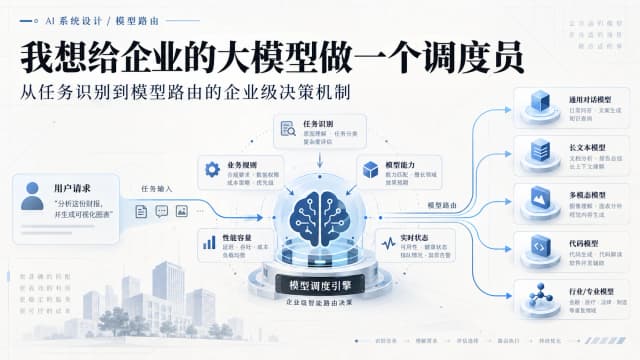
更合理的做法,是把企业里的 AI 请求划成不同等级,再让每一级走对应的模型。
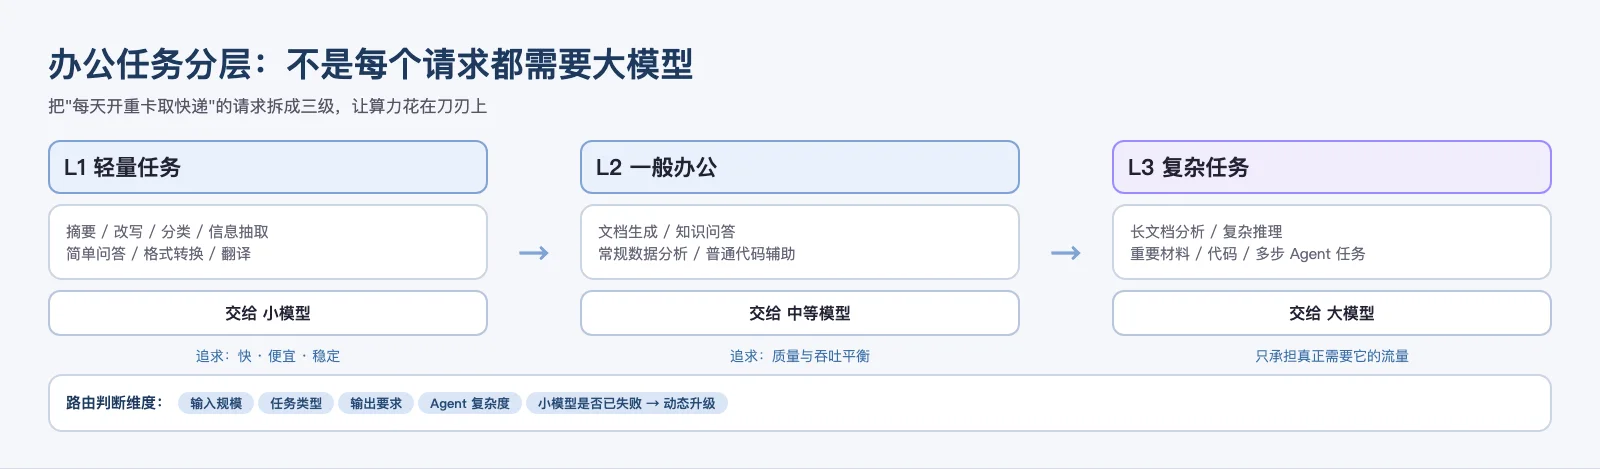
图 2 · 办公任务分层:轻量任务给小模型、一般办公给中等模型、复杂任务给大模型
四、真正难的地方,是「什么时候升级」
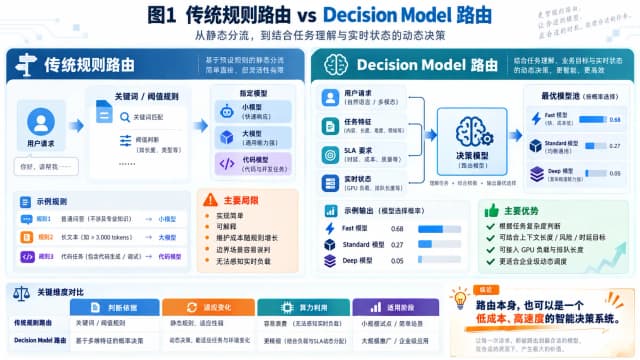
模型路由听上去很简单:简单问题给小模型,复杂问题给大模型。落地之后会发现,「复杂」两个字并不好判断。
用户只输一句「帮我分析一下这份材料」,到底算简单还是复杂?附件只有两页,一个小模型可能就够。附件是一份几百页的制度文件,完全是另一回事。
所以实际做路由,不能只看 Prompt 字数,至少要综合几个维度:
输入规模:Prompt 长度、附件大小、解析后的 Token 数、RAG 召回内容长度。输入越长,对模型能力和显存的要求通常越高。
任务类型:摘要、改写、分类这一类可以优先走小模型;推理、规划、代码、复杂数据分析要提高模型等级。
输出要求:「给我总结成三句话」和「帮我形成一份完整分析报告」,显然应该采用不同策略。
Agent 复杂度:只是一次模型调用相对简单;如果后面要调搜索、数据库、MCP 工具、代码执行,再进多轮推理,模型能力对整体成功率的影响会越来越明显。
还有一个我觉得很关键的维度:小模型是否已经失败。
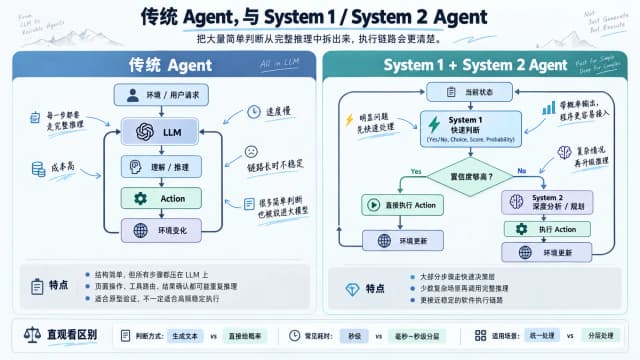
路由没有必要一开始就 100% 判准。完全可以采用「小模型先试 → 质量判断 → 必要时升级大模型」的机制。触发升级的信号可以是:答案置信度低、结构不完整、工具调用失败、引用不足、任务没完成、用户点了「重新生成」,或者干脆再放一个轻量判别模型来判断结果是否需要升级。
这样模型路由就不再是一次静态选择,而是一个动态过程。
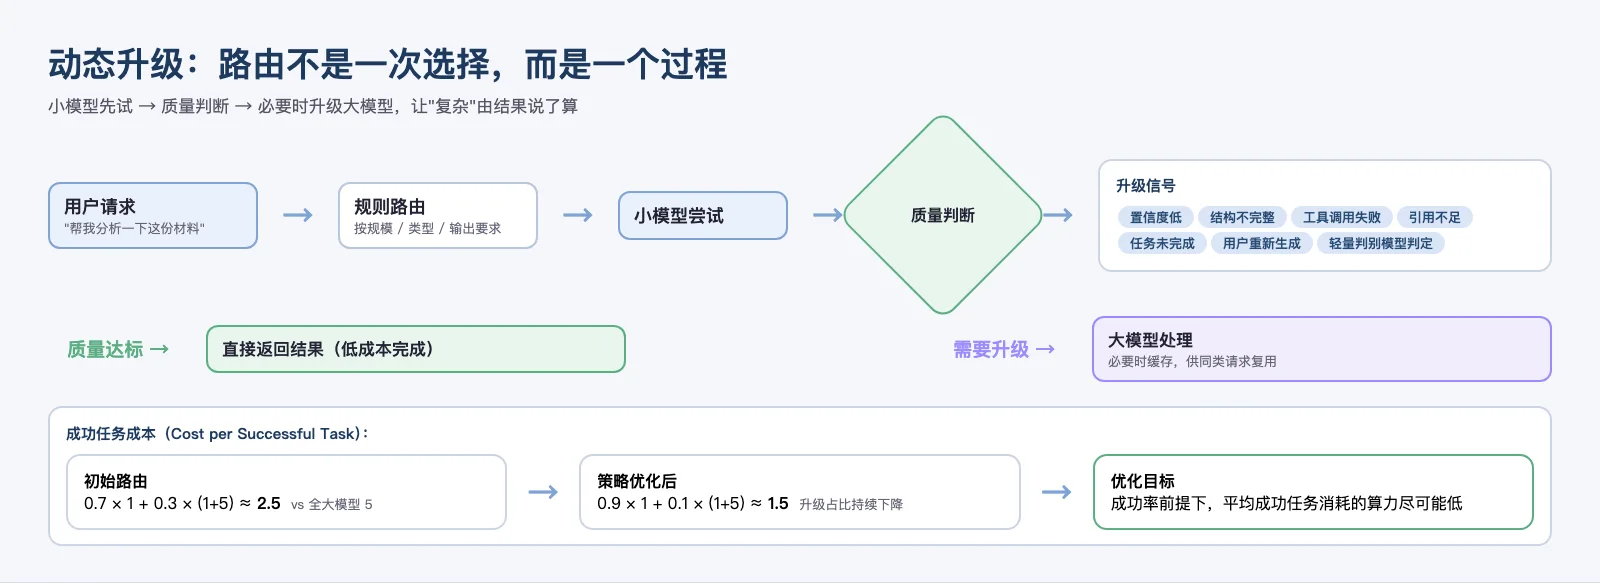
图 3 · 动态升级:小模型先试,质量判断决定是否升级,成功任务成本随路由优化持续下降
五、我更关注一个指标:成功任务成本
如果以后真正评估模型路由,我觉得只算 Token 单价是不够的。可以再加一个指标:Cost per Successful Task,成功任务成本。
举个例子。小模型一次任务成本 1,大模型一次成本 5。表面看小模型便宜很多。但如果小模型只有 70% 的任务能直接完成,剩下 30% 最终还要升级到大模型,实际成本是:
0.7 × 1 + 0.3 × (1 + 5) ≈ 2.5
仍然比全部走大模型的 5 便宜。而如果路由策略不断优化,只有 10% 的请求需要升级,成本就变成:
0.9 × 1 + 0.1 × (1 + 5) ≈ 1.5
经济性就非常明显了。
所以模型路由真正应该优化的,不是「小模型调用占比越高越好」,而是在保证任务成功率的前提下,让平均每个成功任务消耗的算力尽可能低。这比简单比较模型单价,更接近企业真实的成本。
六、私有化部署还要再算一笔「并发账」
对私有化部署来说,模型路由还有一个经常被低估的价值:它可以直接提高现有算力覆盖的人数。
一组 GPU 跑一个大模型,在长上下文条件下可能只能承载很有限的并发。如果其中 70% 的普通请求被导向更轻量的模型,大模型真正要承担的请求就只剩 30%。同一批硬件,服务能力可能完全不一样。
这里甚至可以定义一个更简单的指标:单位算力有效任务吞吐,也就是「单位时间成功完成的有效任务数 / 占用的 GPU 资源」。企业真正应该优化的,可能不是某个模型的峰值 Token/s,而是这个 E。因为最后买服务器、买 GPU、扩容集群的时候,真正关心的是:这些机器每天究竟能替多少人完成多少件事。
七、模型路由其实是在做「算力预算管理」
换一个角度看,模型路由和云计算里的资源调度很像。GPU 算力可以理解成企业的一种有限预算。如果每一个请求都允许使用最贵的资源,预算很快就会耗完。
一个成熟的企业智能体平台,未来很可能需要类似这样的策略:普通用户每天默认拥有一定的大模型额度;简单任务优先使用轻量模型;复杂任务自动升级;高价值业务场景具有更高优先级;高峰期动态降低部分任务的模型等级;低峰期适当放宽;重要报告、关键业务分析允许显式选择高级模型。
走到这里,模型路由其实已经不只是一个 AI 算法问题了。它逐渐变成了企业 AI 算力的资源调度问题。
八、大模型应该成为「高级能力」,而不是所有请求的默认入口
我现在比较认可的一种产品设计,是把不同模型能力做成用户能够理解的层级。类似很多软件里的:普通模式、专业模式、深度分析。
用户每天大量使用的,其实应该是普通模式——响应快、随时可用。真正遇到复杂任务,再进入高级模型。长期看,甚至可以让用户逐渐理解:什么时候需要大模型,什么时候普通模型已经足够。
这其实也是一种 AI 素养。就像我们不会为了算一个加减法启动大型数据分析平台一样,未来用户可能也会自然地理解:这件事情,用一个小模型就够了。
九、质量与覆盖,我更愿意分阶段看
回到开头那个问题:企业 AI 应该优先追求质量,还是优先追求覆盖?
我觉得没有一个永久固定的答案。但如果处在 AI 刚开始大规模推广的阶段,我会更关注覆盖。可以粗略分成三个阶段:
第一阶段:有没有 AI 可以用。
第二阶段:AI 好不好用。
第三阶段:哪些工作可以围绕 AI 重新设计。
如果第一阶段都没形成足够广的用户基础,就直接追求第三阶段,很多建设最后容易变成少数人的高级工具。
对几千、几万人规模的组织来说,我更希望先看到这样的变化:100 个人每天都在用 AI,慢慢变成 500、1000、更多人。然后这些用户逐渐从「改写一句话、总结一份材料、查一个知识点」,进阶到「写完整材料、分析数据、调用工具、执行工作流、用 Agent 完成复杂任务」。这时候再给他们越来越强的模型,价值会越来越明显。
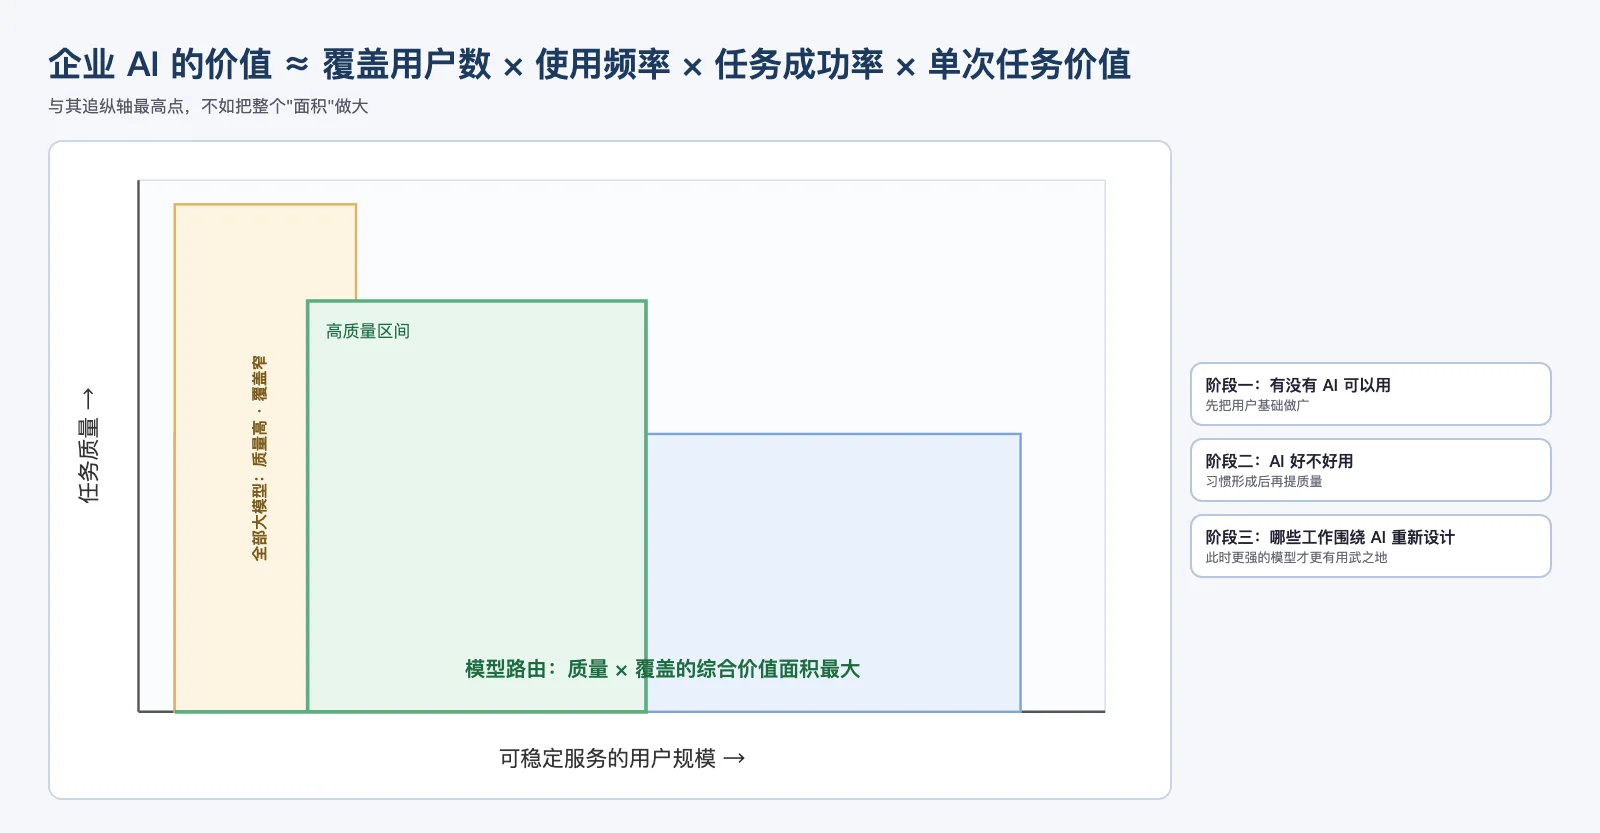
图 4 · 企业 AI 的价值 ≈ 覆盖 × 频率 × 成功率 × 单次任务价值:模型路由追求的是把整个面积做大
十、真正值得追求的,可能是「能力覆盖面积」
如果把模型质量作为纵轴,能覆盖的用户数量作为横轴。企业 AI 真正应该追求的,也许不是纵轴最高的那一个点,而是整个矩形的面积。
粗略可以写成:
AI 价值 ≈ 用户覆盖率 × 使用频率 × 任务成功率 × 单次任务价值
模型能力当然会影响任务成功率,但它只是其中一个变量。如果为了把成功率从 90% 提到 95%,导致可稳定服务的用户从 3000 降到 300,这笔账就值得重新算一遍。
这也是为什么我现在越来越关注模型路由。它的意义并不只是「省钱」。它让我们有机会在同一套有限算力里,同时保住两件事:一边把 AI 能力铺出去,一边把真正昂贵的模型留给值得使用它的任务。
写在最后
这一轮企业 AI 建设做下来,我有一个越来越明确的感受。
真正的大规模应用,最终一定会碰到算力问题。模型越来越强以后,这个问题不会消失,反而可能越来越明显:上下文越来越长、Agent 调用越来越复杂、用户数量越来越多、一个用户请求背后可能连续触发很多次模型调用。如果仍然把「所有任务都交给最强模型」作为默认方案,资源永远会显得不够。
所以模型路由迟早会从一个技术优化项,变成企业 AI 平台的基础能力。
模型能力仍然重要。但对于企业来说,更值得计算的问题可能是:
同样 100 张 GPU,我到底是让 100 个人获得 95 分的体验,还是让 1000 个人先获得 80 分的体验?
至少在 AI 使用习惯还远没有形成的今天,我更愿意先把后面这 1000 个人拉进来。让 AI 先真正进入每个人的办公桌。等大家已经习惯于随手调用 AI 的时候,再一点一点把模型能力、任务复杂度和使用深度往上推。
那时候,更强的模型才真正有了更大的用武之地。