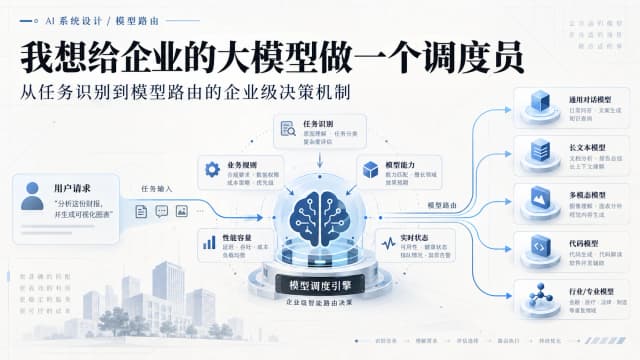
把 JEV / Laya 放到模型前面:模型路由也许应该先学会“判断”
与其用大模型判断该调哪个大模型,不如让几十毫秒的决策模型坐在所有模型前面:结合任务特征、SLA 与实时算力状态,做企业 AI 的请求分流。
最近在研究 JEV 和 Laya 的时候,我突然想到一个挺有意思的用法。
如果它们不直接回答用户的问题,而是坐在所有大模型前面,专门负责一件事:
判断这一次请求,到底应该交给哪个模型。
这个事情可能比单纯拿它们做分类、审核、评分更有价值。
尤其是在企业内部部署大模型的时候。
因为我们现在真正缺的,很多时候已经不是“有没有更强的模型”,而是:
有限的算力,到底应该分给谁。
一、现在的模型路由,很多其实还是规则路由
假设一个企业内部已经部署了三档模型。
轻量模型,速度快,成本低;
主力模型,效果和性能相对均衡;
大模型,推理能力最强,但显存占用、Token 消耗和响应时间也最高。
最简单的路由方式当然是写规则。
比如:
普通问答 → 小模型
文档生成 → 主模型
复杂推理 → 大模型
再复杂一点,可以增加一些条件:
输入 > 32K → 大模型
涉及代码 → 编程模型
包含图片 → 多模态模型
知识问答 → RAG + 主模型
这种方式当然能用。
企业里的很多 AI 网关,本质上也就是在做类似的事情。
问题在于,用户真正提交过来的请求很少这么规整。
比如:
“帮我看看这个方案有没有问题。”
到底算简单问答,还是复杂推理?
再比如:
“把附件里的材料整理一下,顺便看看里面几个指标有没有矛盾。”
它可能同时涉及文档解析、信息抽取、逻辑判断和数据分析。
靠关键词越来越难判断。
于是很多系统开始干另外一件事:
先调用一个大模型理解用户意图,再决定调用哪个模型。
逻辑没问题,但工程上多少有点尴尬。
为了节约一次昂贵的大模型调用,我们先调用了一次大模型。
路由层本身就开始消耗 Token、显存和时间。
这也是我最近看到 JEV 和 Laya 后,觉得它们特别适合模型路由的原因。
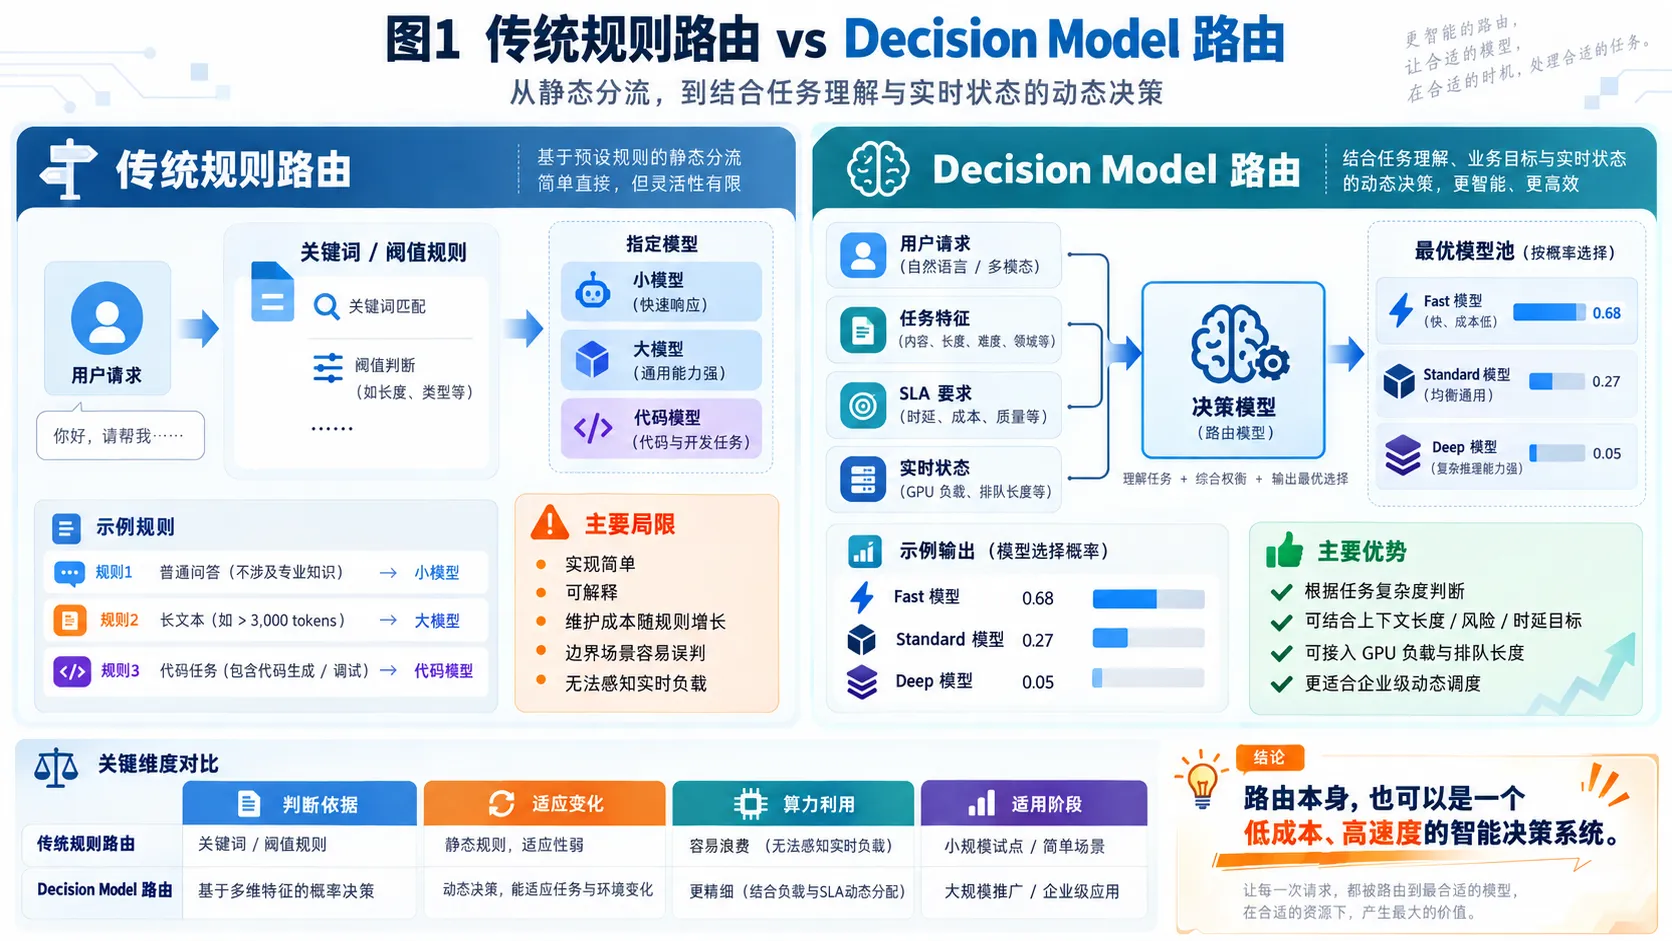
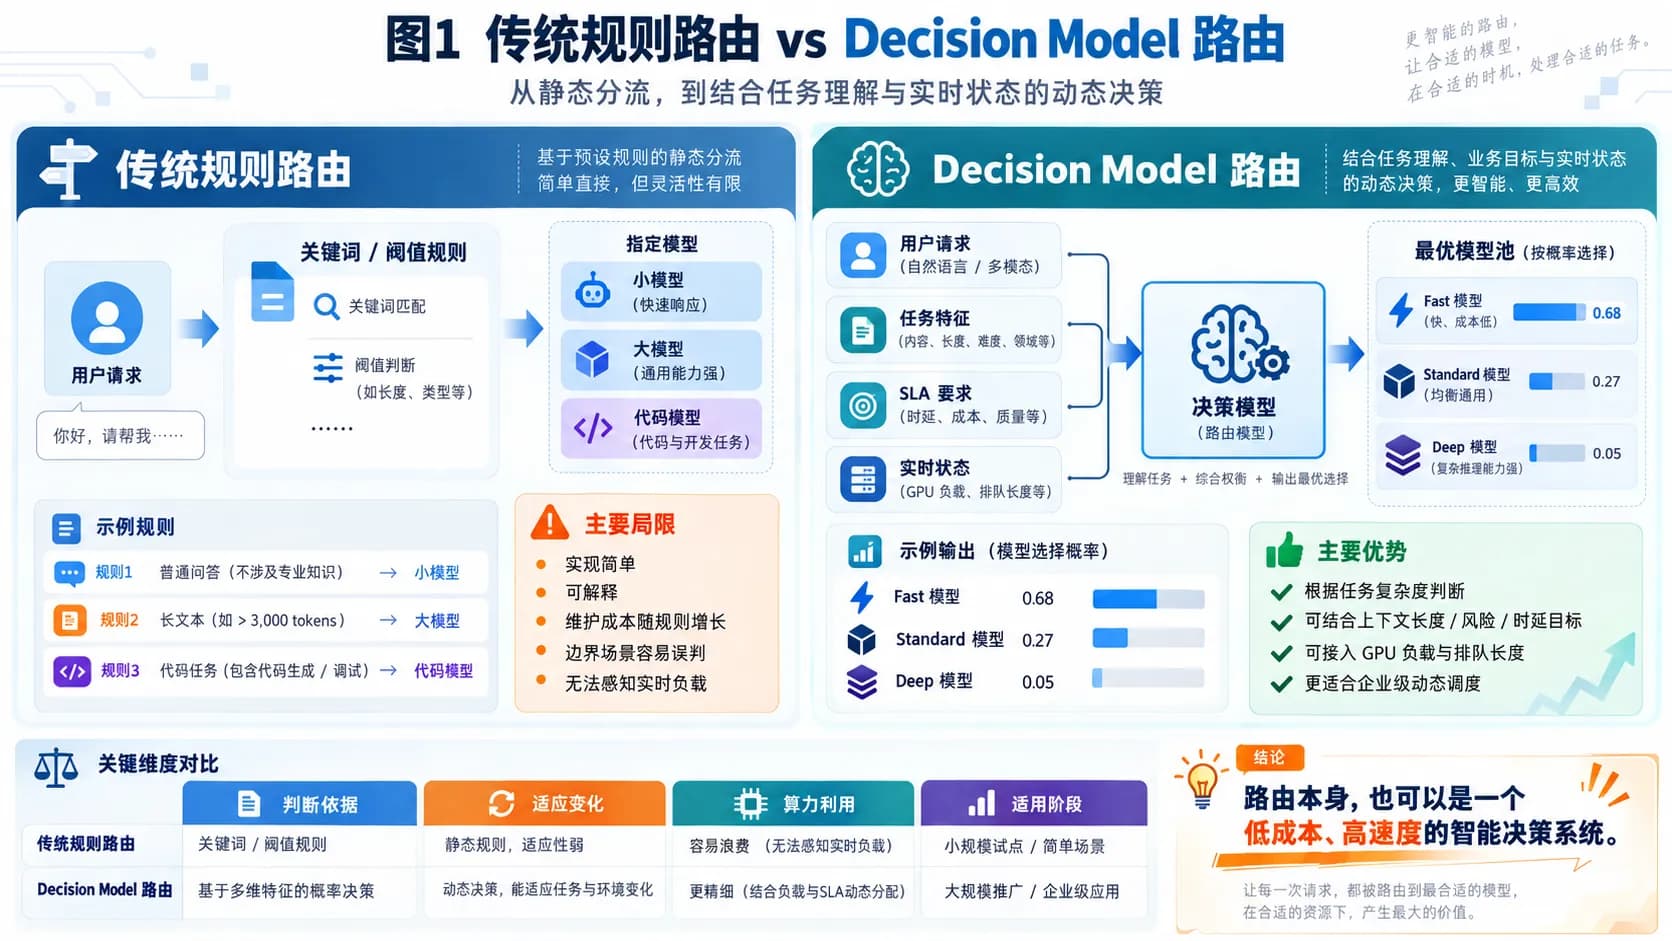
图 1 · 传统规则路由 vs Decision Model 路由:从静态分流,到结合任务理解与实时状态的动态决策
二、JEV 和 Laya 有一个很适合做路由的能力:它们只负责“判断”
Laya 的定位其实非常直接。
它是一个非自回归的 System 1 决策模型。
你给它一段 state,再给它几个明确的问题,它不会像普通 LLM 一样生成一大段文字,而是直接输出选择结果以及对应概率。
比如:
任务复杂度:

简单:0.72
中等:0.24
复杂:0.04
或者:
推荐模型:

Fast Model:0.68
Standard Model:0.27
Reasoning Model:0.05
公开模型卡中,Laya 英文版大约 421M 参数,多语言版约 322M 参数;官方给出的单问题推理延迟大约在几十毫秒量级,而且支持一次 forward 同时判断多个问题。
JEV 的思路更有意思。
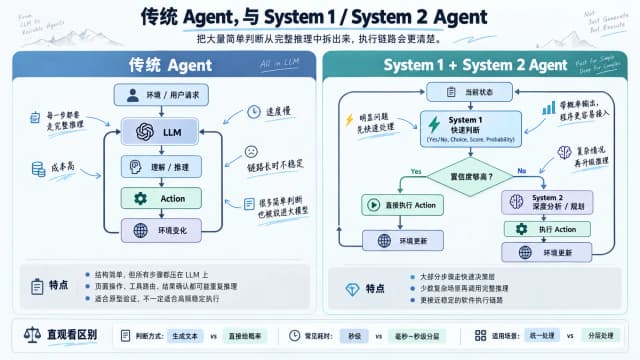
最新的 JEV-27B 在 Qwen3.8-27B 上同时保留了两套能力:
- System 1 负责快速 decision;
- System 2 负责正常的大模型生成和推理。
System 1 可以直接回答 yes/no、choice、0~5 分评分,并返回校准后的概率分布。公开实现甚至直接提供了 /v1/decide 接口。
JEV-27B 的公开测试里,System 1 的一次判断大约可以做到 0.1 秒级。
这个能力拿来做模型路由就很顺。
因为模型路由真正需要的,本来就不是一段自然语言分析。
它最后只需要回答一个问题:
这次请求应该去哪。
三、但我觉得还可以再往前走一步
如果只是根据用户输入判断模型,其实还没有发挥这种 decision model 的价值。
真正有意思的地方,是把 现实运行状态一起塞进去。
也就是说,路由函数可以变成:
Route = f(UserInput, Context, SLA, Risk, RuntimeState)
这里的 RuntimeState 很重要。
假设当前系统里有三套模型:
| 模型池 | 特点 | 当前状态 |
|---|---|---|
| Fast | 小模型、高吞吐 | GPU 42%,无排队 |
| Standard | 主力模型 | GPU 78%,等待 6 个请求 |
| Deep | 大模型、强推理 | GPU 95%,预计排队 18 秒 |
用户现在问:
帮我把这段会议纪要压缩成 300 字。
从能力上看,三个模型都能做。
如果传统路由规则规定“文档生成统一走 Standard”,请求还是会进入 Standard。
但如果把当前运行状态一起交给决策模型,它完全可以得到这样的结果:
Fast      0.81
Standard  0.17
Deep      0.02
于是请求直接进入 Fast。
用户很可能两三秒就拿到了结果。
这时候,模型路由开始真正和 算力调度 结合起来了。
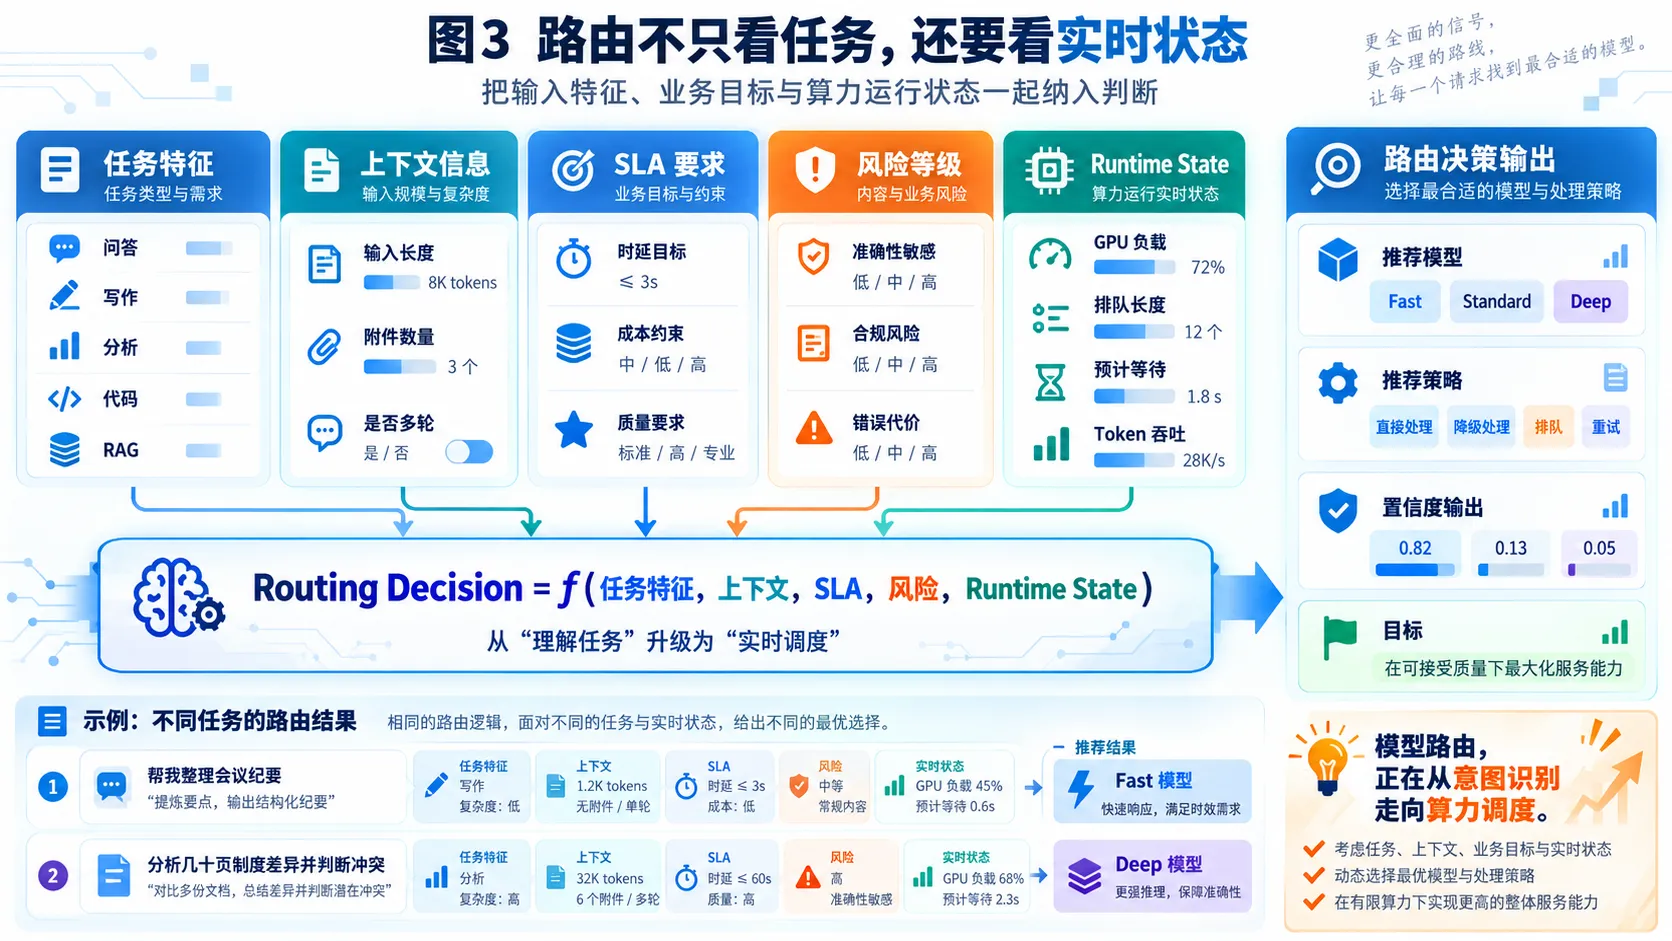
图 2 · 路由不只看任务,还要看实时状态:把输入特征、业务目标与算力运行状态一起纳入判断
四、甚至可以让路由器一次判断很多东西
Laya 有一点我很喜欢:一次请求可以同时判断多个 typed question。
因此我们完全没有必要只问一句:
“应该使用哪个模型?”
可以同时判断多个维度。
例如:
| 判断项 | 可能输出 |
|---|---|
| 任务类型 | 问答 / 写作 / 分析 / 代码 / RAG |
| 任务复杂度 | Low / Medium / High |
| 推理需求 | 0.18 |
| 长上下文需求 | 0.74 |
| 准确性敏感度 | 0.91 |
| 实时性要求 | 0.83 |
| 工具调用概率 | 0.27 |
| 高风险任务概率 | 0.06 |
| 推荐模型 | Fast / Standard / Deep |
这样一来,模型路由就不再是简单分类。
它会形成一个比较完整的 任务画像。
然后再由策略层结合系统运行状态做最终选择。
我反而建议保留这一层。
决策模型负责判断:
这个任务是什么?
策略系统负责决定:
在当前资源条件下,我准备怎么处理它?
这样会比把所有权力直接交给模型稳很多。
五、比如一个办公智能体,可以这样工作
假设员工输入:
帮我写一段会议通知,明天下午三点在三楼会议室讨论季度工作安排。
路由器判断:
复杂度:Low 0.96
推理需求:0.03
长上下文:0.01
高准确性要求:0.18
直接进入轻量模型。
另一个人上传了一份几十页的制度文件:
帮我找出这份制度和去年的版本有哪些变化,并分析几个条款是否存在冲突。
判断结果可能变成:
复杂度:High 0.91
推理需求:0.88
长上下文:0.94
准确性要求:0.97
这时候才进入强模型。
还有一种情况更有意思。
用户只是说:
帮我润色一下。
任务非常简单。
但当前 Fast Model 已经排队 40 个请求,预计等待 15 秒,Standard Model 反而空闲。
系统完全可以临时把请求发给 Standard。
这里已经很接近操作系统里的调度器了。
CPU Scheduler 调度进程。
AI Router 调度 Token。
六、这件事对企业 AI 真正有价值的地方,其实是“分层服务”
企业推广 AI 经常有一个矛盾。
大家当然都希望每个人都使用最强模型。
可算力通常不允许。
于是很容易出现一种情况:
模型很好,回答质量也很好,但几十个人同时用以后开始排队。
最后几千人的 AI 平台,真正能够舒服使用的人只有很少一部分。
我一直觉得这种状态有点可惜。
很多办公任务其实没有必要占用最昂贵的模型。
邮件润色、标题生成、会议纪要整理、文本分类、普通知识问答,小模型完全可能已经够用了。
真正需要强模型的,是复杂分析、长文档理解、代码、高难度推理以及一些高准确性场景。
如果所有请求都直接进入最大模型,相当于公司班车只有劳斯莱斯。
车当然很好。
问题是坐不了几个人。
模型路由做得好以后,企业 AI 的算力结构可能变成:
- 大量简单请求 → 小模型
- 普通办公任务 → 主模型
- 少量复杂任务 → 强模型
最终追求的也就不再是:
每个人每一次都使用最强模型。
而是:
在用户能够接受的质量范围内,让尽可能多的人获得足够好的 AI 服务。
这两种思路对算力规划的结果会完全不同。
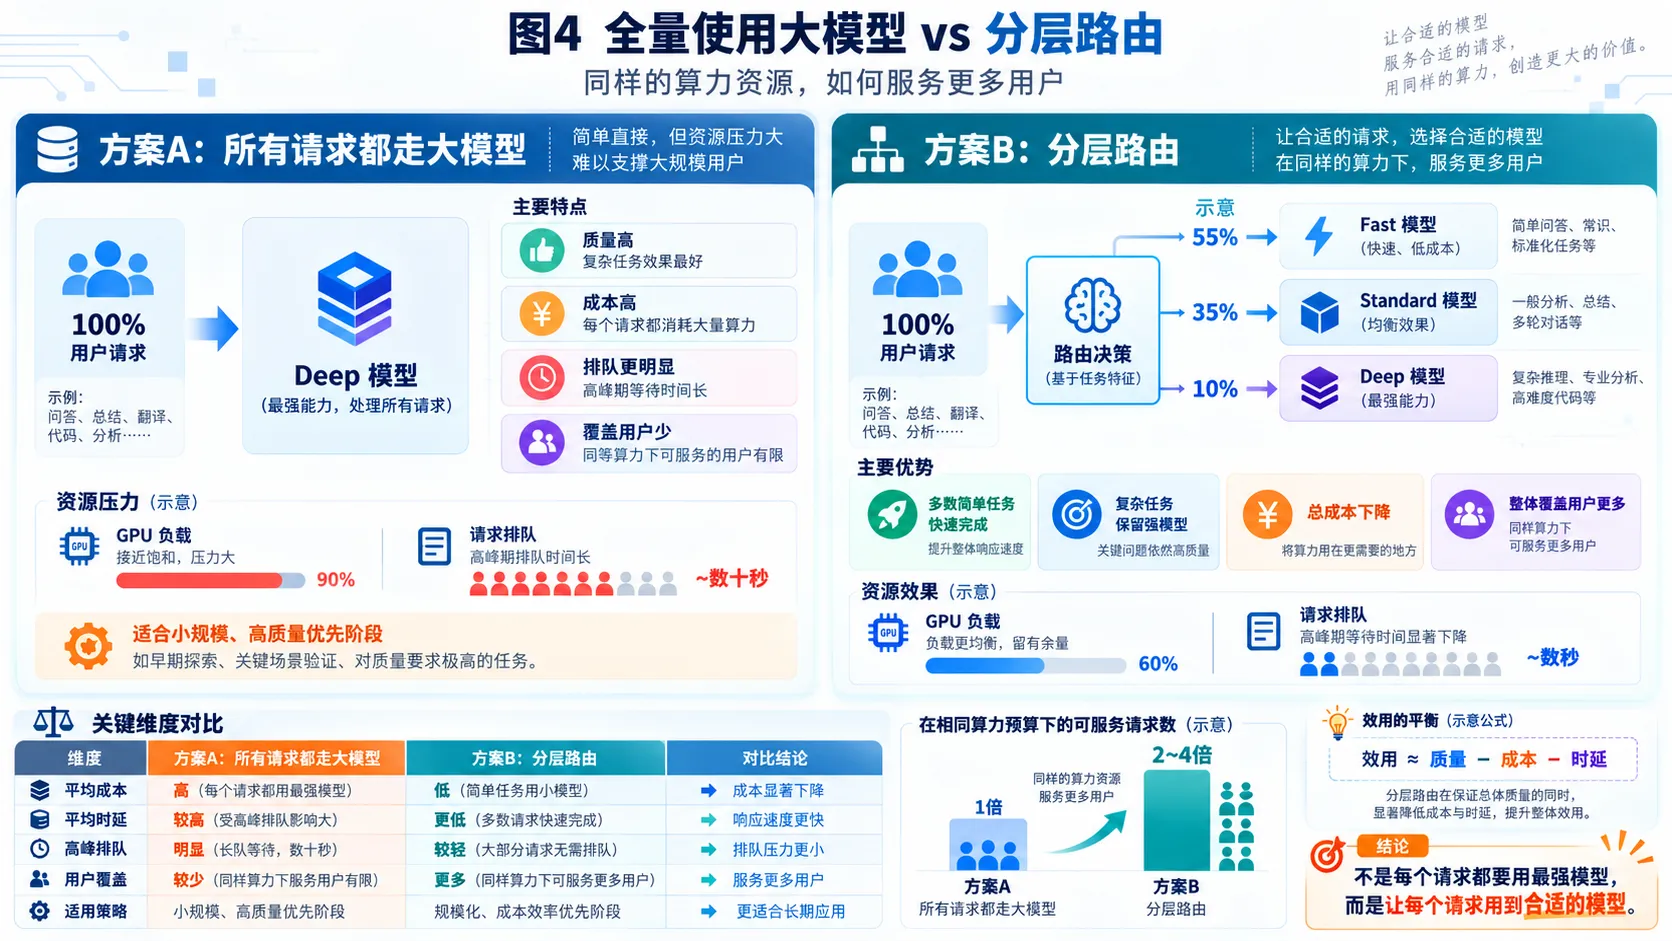
图 3 · 全量使用大模型 vs 分层路由:同样的算力资源,如何服务更多用户
七、JEV 和 Laya 如果真拿来做路由,我可能会这样分工
这两个模型虽然都能做 decision,但我不会简单二选一。
Laya 很适合放在最前面的热路径。
它的参数规模只有几亿,非生成式,一次 forward 就能完成判断。公开模型卡给出的多语言版本单问题延迟约 32.8ms,多个问题还可以批量判断。
对一个每天几十万、甚至几百万次模型调用的平台来说,这个量级很重要。
因为模型路由本身也有成本。
假设为了节约 20% 的大模型算力,却给每一个请求增加了一个 27B 模型调用,最后这套经济账可能根本算不过来。
所以第一层可以是:
Laya → 高频、低成本、快速任务分流。
JEV 则可以处理更复杂的判断。
JEV-27B 本身就是 27B 规模,模型权重约 55GB,System 1 虽然判断很快,但资源占用显然远大于几亿参数的 encoder 模型。
它的优势在另外一些地方。
比如长上下文。
JEV-27B 的 System 1 公开支持最高 256K 上下文的 typed decision。
再比如 JEV-27B-VL 已经可以直接针对图片和文本一起进行判断。
于是可以设计成两级路由:
                    用户请求
                       │
                       ▼
                 Laya 快速判断
                 30~50ms 级
                  /        \
          高置信度          低置信度
             │                 │
             ▼                 ▼
        直接选择模型        JEV 深度判断
                               │
                               ▼
                         最终选择模型
我觉得这种结构非常有意思。
大量简单请求几十毫秒内完成路由。
只有那些“看不太懂”的任务,才消耗更昂贵的 JEV。
这和现在很多系统里的大小模型级联思路是一致的,只不过这里级联的是 决策能力。
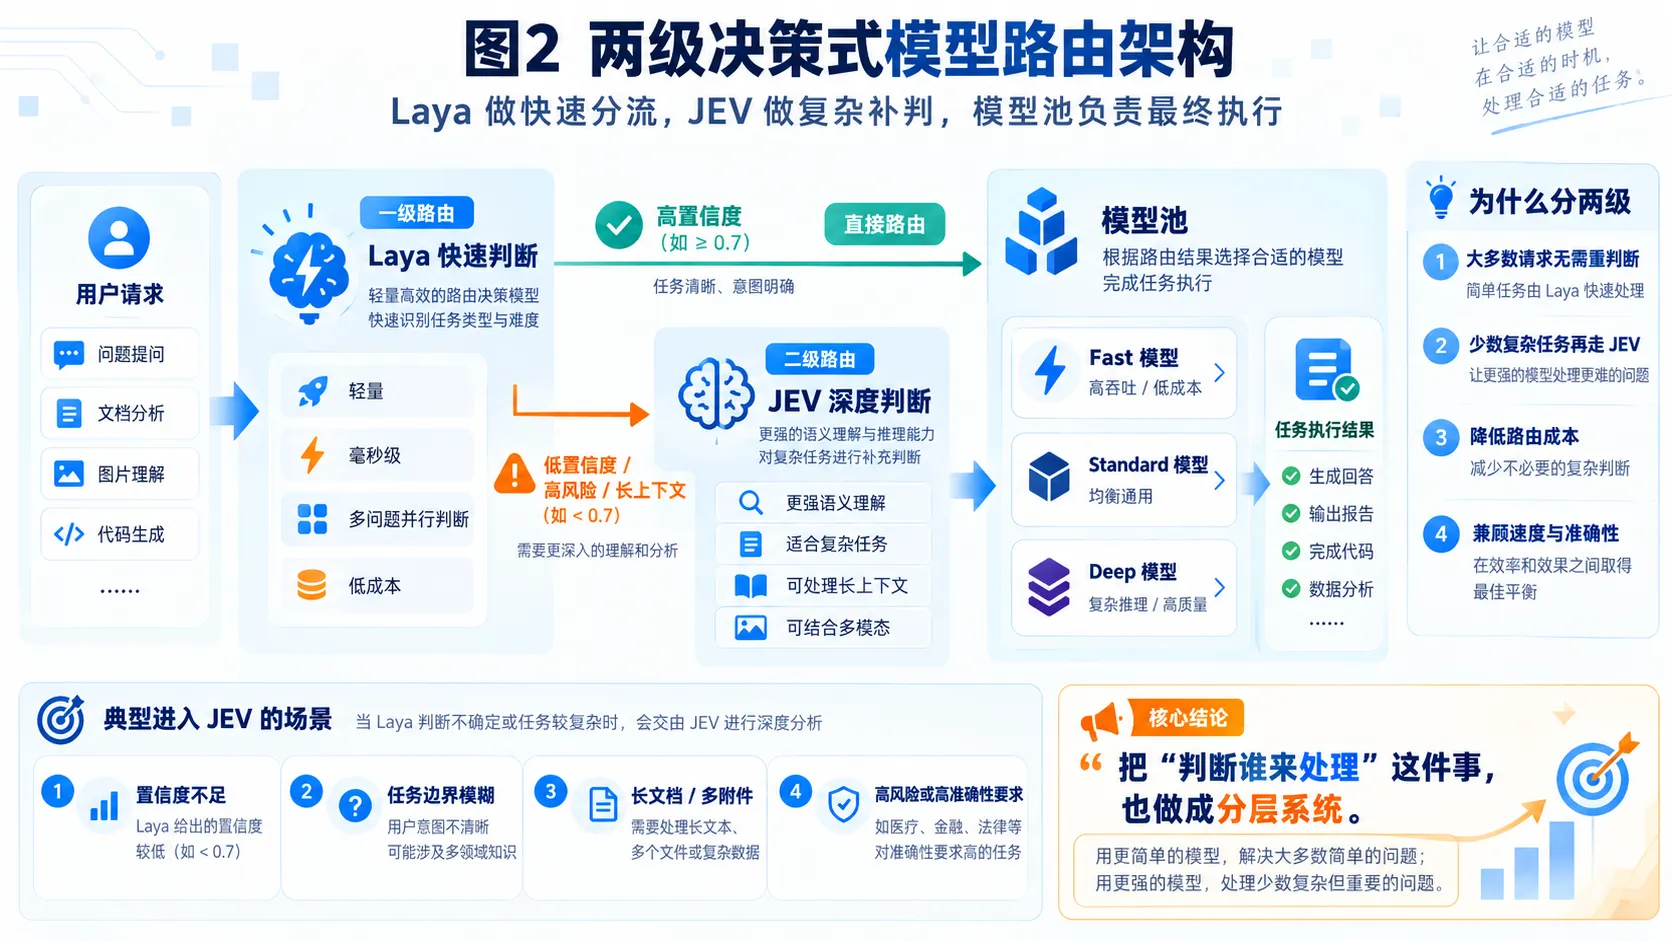
图 4 · 两级决策式模型路由架构:Laya 做快速分流,JEV 做复杂补判,模型池负责最终执行
八、概率输出可能比“模型名称”更重要
这也是我觉得 JEV 和 Laya 比普通分类器有意思的地方。
路由器最好不要只回答:
model = glm真正有价值的应该是:
Fast       0.46
Standard   0.43
Deep       0.11
因为这意味着:
路由器自己也没有把握。
系统就可以设置一个规则:
Confidence < 0.7 则进入二级判断。
或者:
P(HighRisk) > 0.8 强制进入高质量模型。
甚至:
P(Fast) > 0.8 并且 Queue_Fast < Threshold 才真正进入 Fast。
模型输出概率。
策略引擎制定规则。
这样整个系统会变得非常容易控制。
九、真正难的其实是训练自己的 Routing Benchmark
真要做这个东西,我觉得技术本身反而没有那么难。
最难的可能是:
什么叫“路由正确”?
如果一个问题小模型回答得很好,那么送给大模型虽然不能算错误,但浪费算力。
如果一个复杂问题送给小模型,最后答案质量下降,这显然属于错误路由。
所以 Routing Benchmark 至少要同时考虑三个变量:
Utility = Quality − λ·Cost − μ·Latency
也就是:
质量、成本、响应时间。
最终评估的已经不是简单 Accuracy。
而是:
在保证一定质量的情况下,能不能减少大模型调用比例?
比如原来:
100% 请求 → 70B 模型经过路由以后:
55% → 7B
35% → 27B
10% → 70B
而最终整体质量只下降 1%。
那么从企业 AI 的角度看,这可能是一次非常成功的优化。
因为同样的算力,可以服务更多人。
十、我觉得这可能会成为 AI 基础设施里很重要的一层
过去我们讨论 AI 基础设施,关注比较多的是:
模型服务、推理引擎、KV Cache、PD 分离、量化、并发、Token/s。
这些当然都重要。
但它们大部分解决的是:
一块 GPU 怎么跑得更快。
模型路由解决的是另外一个问题:
这个请求究竟有没有必要占用这块 GPU。
前者是在提高供给能力。
后者是在控制需求。
当一个企业内部只有几十个 AI 用户的时候,路由可能没有那么重要。
模型够强,全部扔给它就行。
但当 AI 真正开始从几十个人走向几千人、几万人时,每一次请求到底应该消耗多少算力,就会成为一个非常现实的问题。
这时候,一个几十毫秒完成判断的模型,也许反而会成为整个 AI 平台里性价比最高的模型之一。
它自己不写材料。
不回答问题。
不生成代码。
甚至用户根本不知道它存在。
它只站在所有模型前面,每次看一眼用户的问题,再看一眼当前系统:
这个问题,交给谁最合适?
我觉得这可能才是 JEV、Laya 这一类 decision model 在企业 AI 中真正值得研究的方向。
让大模型负责思考,让小模型负责决定谁来思考。
如果再把实时算力负载、排队情况和成本放进来,它甚至可以再往前一步:
从模型路由,变成 AI 算力的实时调度器。