JEV-27B-VL:Agent 里那些其实不用认真思考的事情
JEV-27B-VL 把快速概率判断和深度推理放进同一个模型。真正值得关注的不是又一个 27B 模型,而是 Agent 执行链路里可能被拆出来的那一层:Decision Layer。
最近看到一个挺有意思的模型:JEV-27B-VL。
前段时间刚研究过 Jev 和 Laya,所以看到这个名字的时候,第一反应是:这应该又是那个做概率判断的模型,只是加了个视觉版本。
顺着模型卡和项目介绍往下看,发现它比这个想象复杂一些。
它里面有一套很明确的设计思路:把 Agent 运行过程中大量的简单判断,和真正需要推理的任务分开处理。
这件事刚好和我最近做 Agent、做浏览器自动化时碰到的一些问题对得上,所以干脆把它从头理了一遍。
一、Agent 里很多步骤,其实只是判断
现在做一个智能体,常见的处理流程大概是这样:用户输入进来,先交给大模型理解,然后让模型判断意图、决定调用哪个工具、组织工具参数、分析工具结果,再决定下一步。中间的很多环节都会再调一次模型。
比如用户说「帮我查一下这个客户昨天有没有发生风险预警」,系统后面可能要连续做几次判断:
这是知识问答还是业务查询?
要查数据库还是知识库?
该调用哪个 MCP 工具?
查出来的数据够不够?
要不要继续查?
有没有必要转人工?
这些步骤放到代码里看,很多其实都是很简单的决策:Yes / No,或者 A / B / C / D,再复杂一点,也就是「风险程度:0~5」。
比较常见的做法,是继续交给 LLM。让模型判断意图属于哪一类,再按 JSON 格式输出,最后拿到一个 {"intent": "B", "confidence": 0.93"}。
这套方式当然能用,但仔细做几次就会发现几个细节问题。
模型要完整走一次推理和生成过程,最后只是为了得到一个 B。同时还要考虑 JSON 格式稳不稳定、字段会不会丢、模型会不会多输出几句解释、解析失败之后怎么重试。
为了做一次分类,调用了一整个生成式大模型。从工程角度看,有点重。
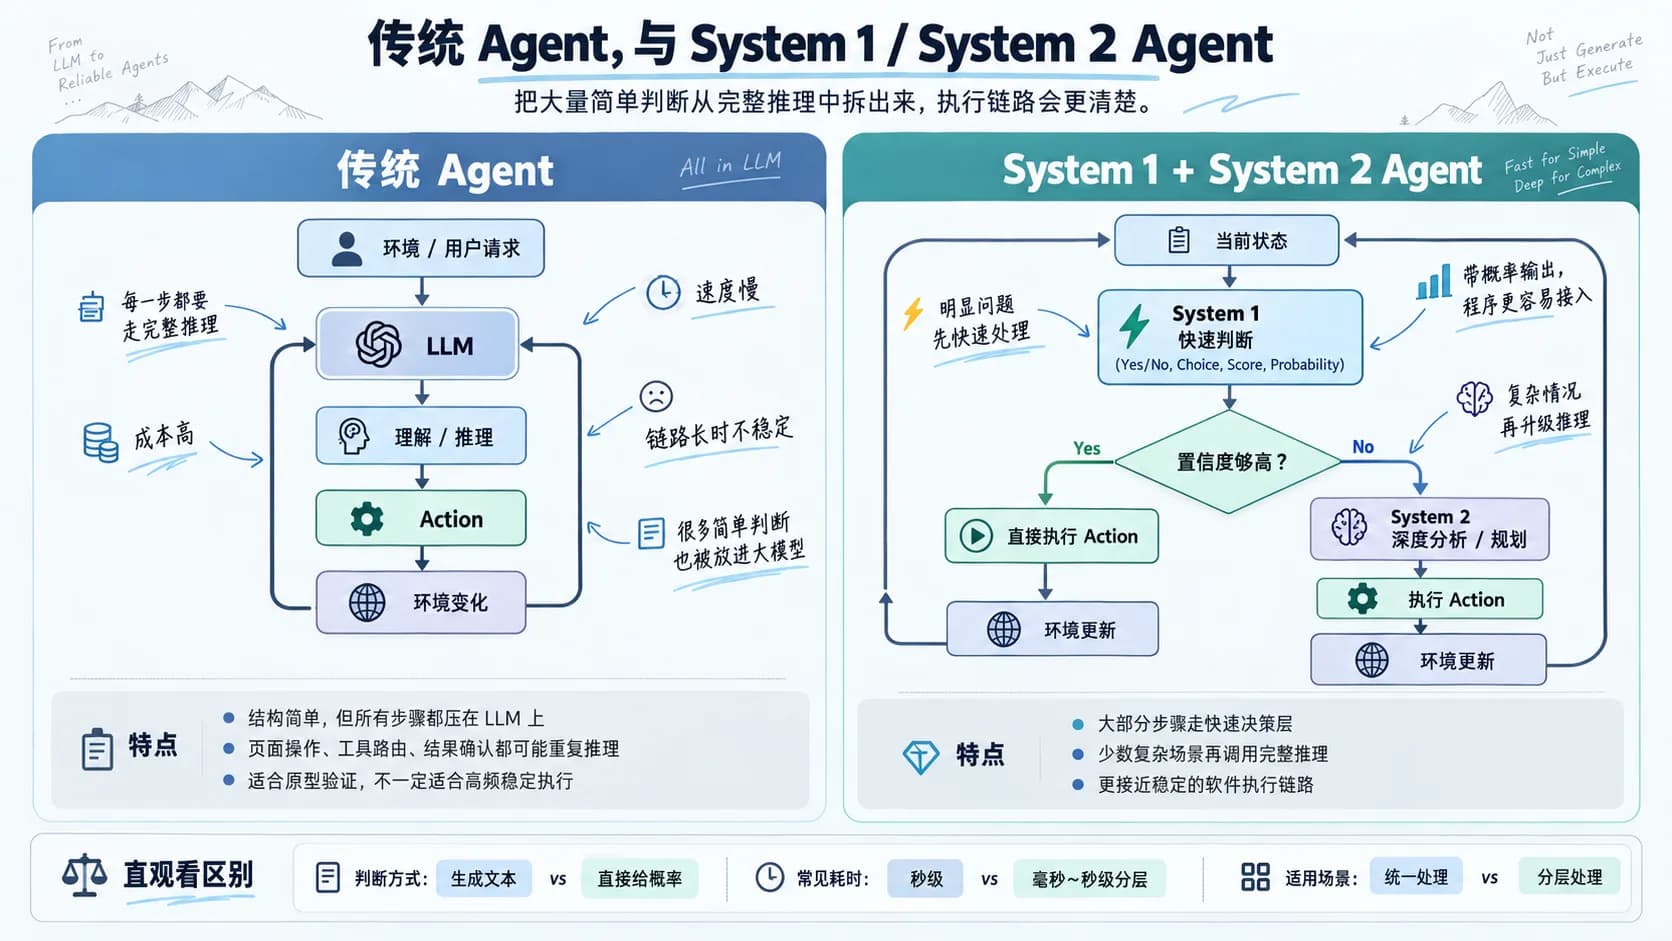
图 1 · 传统 Agent 与 System 1 / System 2 Agent:把大量简单判断从完整推理中拆出来,执行链路会更清楚
二、Jev:把「判断」从「生成」里拆出来
Jev 出来的时候,我就对这个方向比较感兴趣。TypeSafe 把这类模型称为 System One Model。
这个名字来自《思考,快与慢》里常说的 System 1 和 System 2。System 1 负责快速判断,System 2 负责复杂分析。而现在的大语言模型,基本都在不断强化后者:参数越来越大,Reasoning 越来越长,Thinking Token 也越来越多。
Jev 走的是另一条路线。它不负责生成一段自然语言。给它一段状态,再给它一个问题,它直接输出概率。
比如:
当前状态:用户连续三次登录失败,账户昨天刚刚修改密码,设备来自新的 IP 地址。
问题:是否属于高风险登录?
普通 LLM 可能开始分析。Jev 更接近直接返回:
True 0.87False 0.13
还可以一次问多个问题:是否需要阻断?是否需要短信验证?风险等级是多少?应该进入哪个处理流程?最后直接得到几个概率或分数。
TypeSafe 对这个过程有一句概括:unstructured state in, typed probabilistic decisions out。非结构化状态进去,带概率的结构化决策出来。
它输出的不是「生成 JSON」这种结构化输出,而是模型接口这一层本来就输出固定类型的决策:Yes/No、Choice、Score。翻成工程语言,就是把一堆非结构化信息交进去,拿回来的是程序可以直接用的决策结果。一个是在生成文本,一个是在做判断,底层逻辑其实不太一样。
三、Laya:把这件事做得很轻
后来又看到了 Laya,做的事情和 Jev 很接近,但更工程化。
它是一个约 4 亿参数的开源小模型,底层是 ModernBERT-large 加一个专门的决策头。同样不写回答、不生成文字,直接做概率判断。官方展示的典型 GPU 推理延迟大概只有几十毫秒,还支持一次 forward 批量回答多个问题。
所以当时看完 Laya,我脑子里第一个应用场景就是 Agent 路由:
用户请求 → Laya 快速判断 → 知识问题走 RAG、代码问题走 Code Agent、数据查询走 MCP、高风险任务转人工。
这种场景没必要每次都启动一个几十 B 的大模型。如果一个 4 亿参数的小模型就能把分流判断清楚,整条链路会简单很多。
当然,Laya 也有自己的边界。它很轻,能力范围也窄:主要还是文本判断,不会生成内容,复杂推理有限,长上下文也不是它的强项(主模型默认只有 512 token)。它更像 Agent 里专门负责「快速分流」的一层。
四、JEV-27B-VL:把快速判断和深度推理放进同一个模型
这次看到的 JEV-27B-VL,路线又变了。
先澄清一点:它不是 TypeSafe 官方的 Jev,而是 AutoTrust 做的开源版本,以 TypeSafe Jev 1.13 的输出分布作为老师做蒸馏,底座是 Qwen 系列的一个 27B 多模态模型。
真正有意思的地方在于,它把 System 1 和 System 2 放进了同一个模型体系里。模型内部加了一套专门负责快速决策的 System 1 模块,项目里叫 Blocks of Experts(BoE)。这部分新增的训练参数其实不多,只占整个 27B 底座的很小一部分(大约 0.4%)。
于是同一个模型里有了两种工作方式:一边做 Yes/No、Choice、Score、概率输出;另一边还是完整的大语言模型,可以继续做理解、推理、规划、文本生成。
更关键的是,它是一个模型、一个 vLLM 引擎,请求的时候决定走哪条路。这比单纯再做一个「大一点的分类模型」有意思得多——同一个推理服务里,既可以做快速决策,也保留了完整的生成和推理能力。
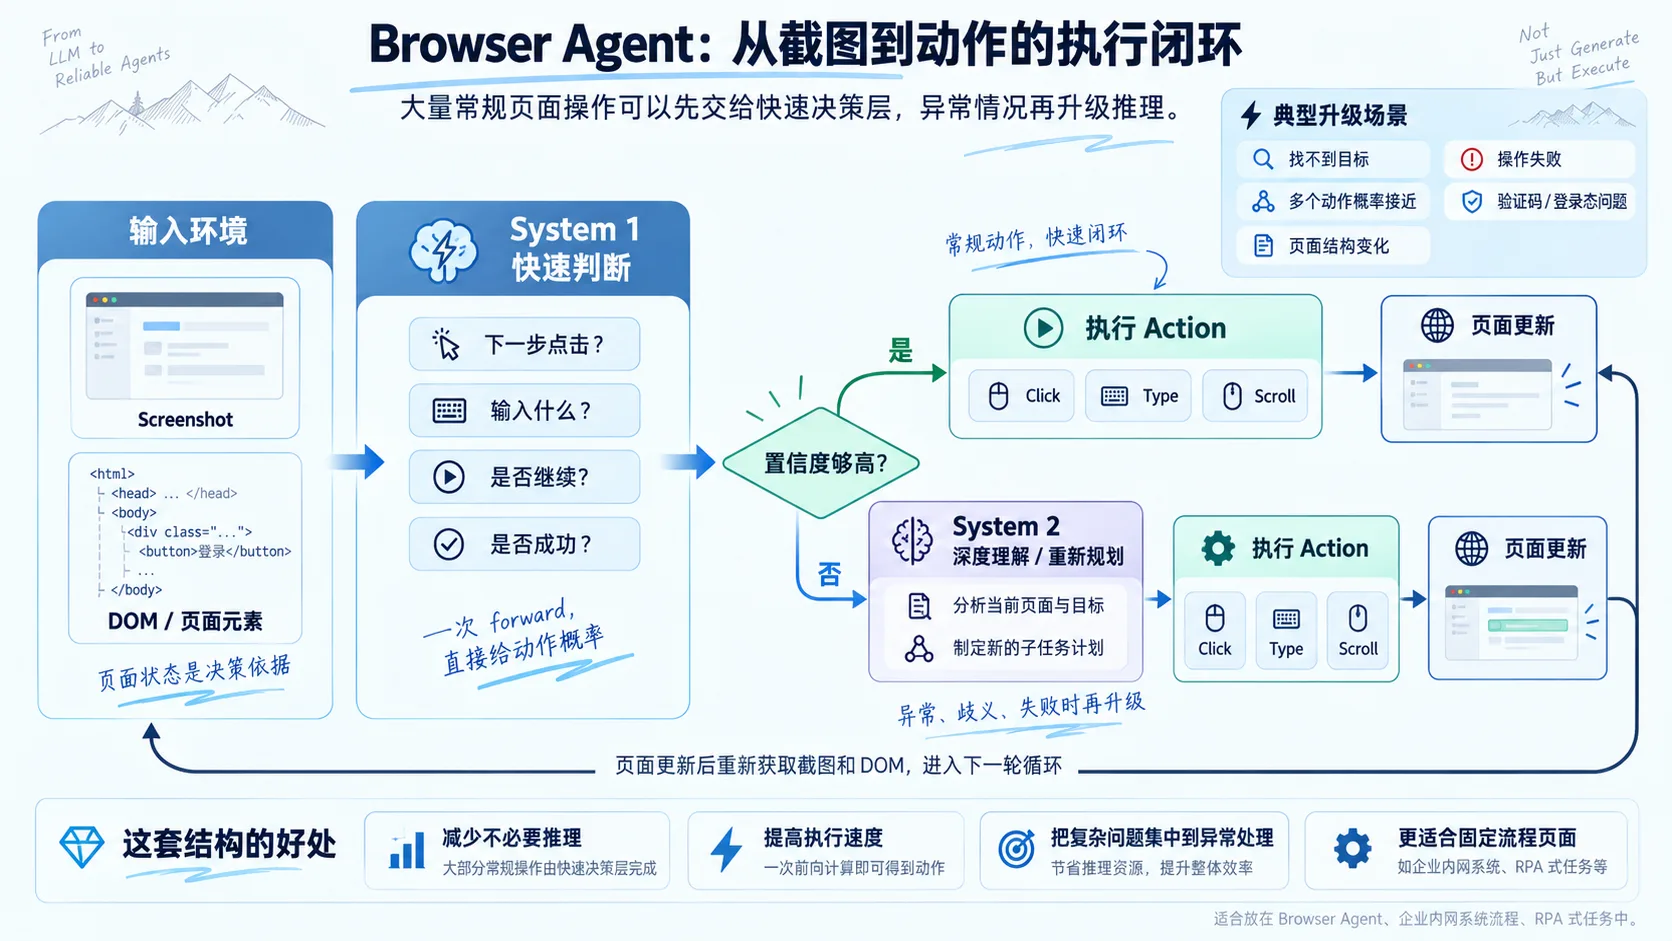
图 2 · 从 Jev 到 Laya,再到 JEV-27B-VL:文本概率决策 → 轻量本地部署 → 视觉决策 + 深度推理
五、VL 版本开始能直接看页面了
名字里的 VL 就是 Vision Language。也就是说,它现在可以把图片直接当成状态输入。
这个能力放到 Agent 里非常好理解。给它一张网页截图,问「下一步应该点哪个元素」,模型可以直接给出:登录 0.91、注册 0.03、忘记密码 0.04、返回首页 0.02。
程序拿到结果甚至可以直接写:if confidence > 0.85: click() else: ask_system_2()
这里少掉了现在 Browser Agent 里很常见的中间步骤。传统方式经常是:看截图 → 生成页面描述 → 分析页面 → 决定操作 → 生成 JSON → 程序解析 → 执行点击。现在可以缩短成:截图 → 判断 → 执行,碰到判断不清楚的情况,再调用深度推理。
项目方最近还用它做了 Computer Use 和机械臂控制的实验。Computer Use 的思路很简单:页面截图进去,把页面元素做编号,让 System 1 判断下一步点哪个。项目报告里,在带元素文本的 60 个多步骤浏览器任务上完成率达到 95%,每次点击决策大约 0.26 秒。机械臂也是一样:摄像头图像进去,判断目标在夹爪左边还是右边、上边还是下边,然后直接控制移动。
这两个 Demo 我觉得比很多 Benchmark 更直观。它说明这种模型已经可以直接放进「感知—判断—动作」这样的闭环里,而不是「视觉 → LLM 描述 → 推理 → JSON → action」。
六、放进 Agent,执行链路会明显变清楚
现在很多 Agent 还是这样跑的:环境进来,走一次完整 LLM 推理,执行动作,环境变化,再走一次 LLM。只要环境变一次,可能就重新调一次模型。一个浏览器任务要操作二十步,就可能连续走二十轮推理。
这里面很多步骤并没有复杂到需要完整推理。页面上已经出现「提交成功」,是否继续?工具返回 HTTP 200、字段齐全,要不要再查一次?页面弹出登录框,下一步是输入用户名还是退出?多数情况下都很好判断。
这些完全可以先交给一个快速决策层。于是 Agent 的流程可以变成:
当前状态 → System 1 快速判断 → 置信度够高?
够了 → 直接执行 → 环境更新;
不够 → System 2 深度分析 / 重新规划 → 执行 → 环境更新。
这样的 Agent 会更像正常的软件系统:大部分流程稳定执行,少数复杂情况再动用大模型。
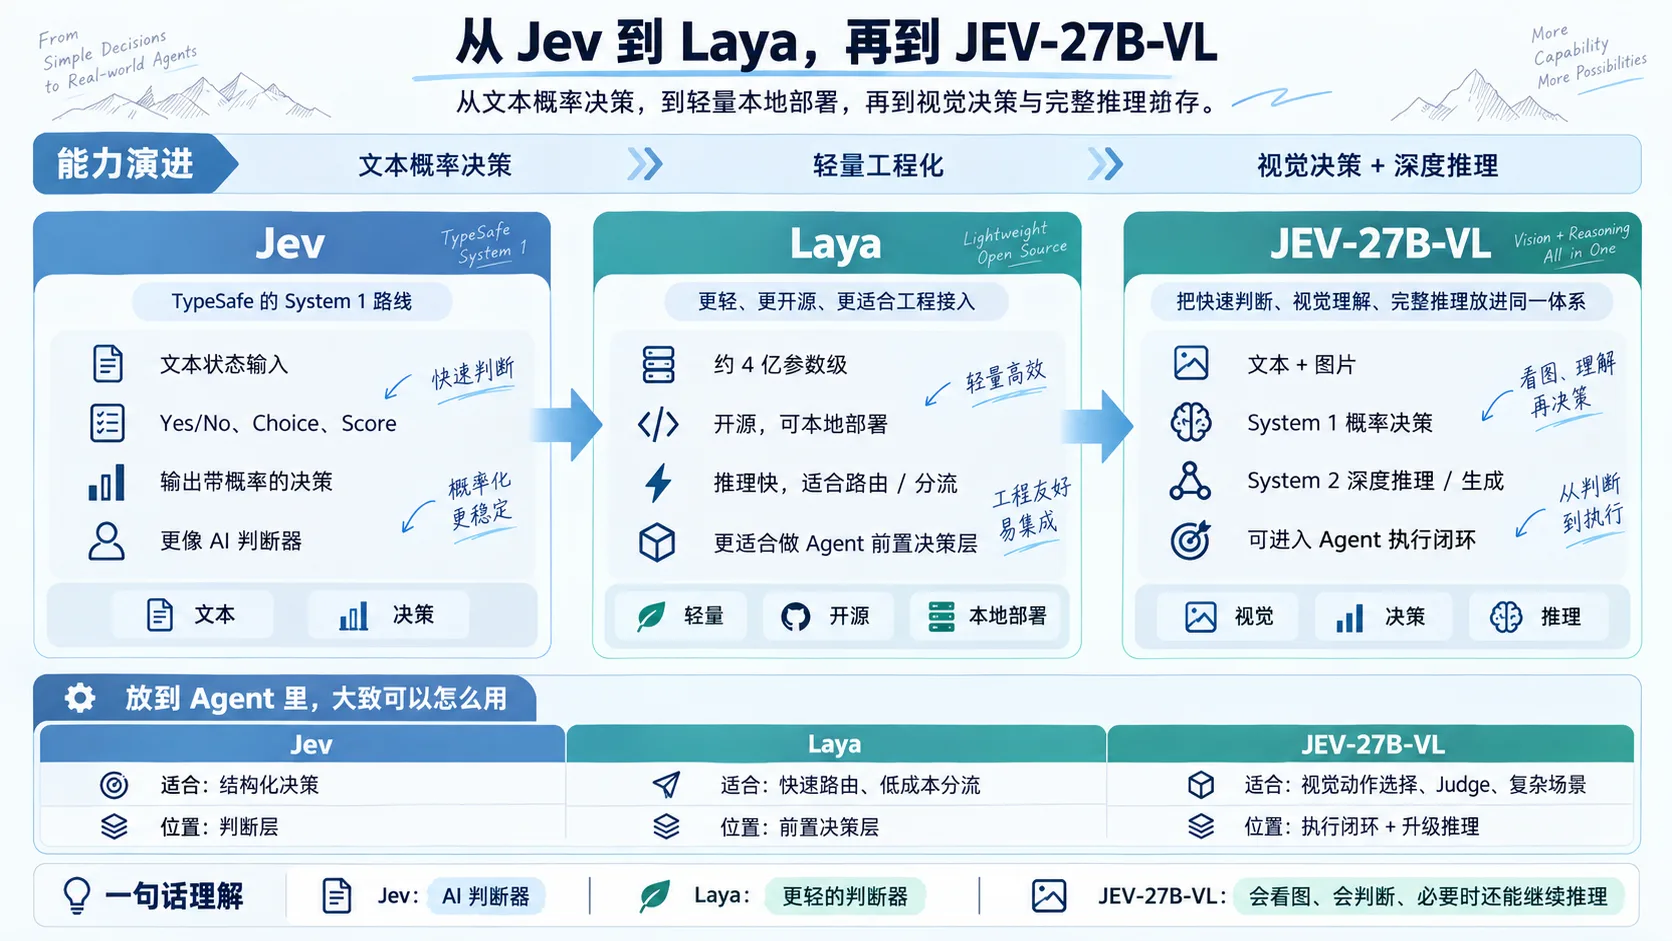
图 3 · Browser Agent 从截图到动作的执行闭环:常规操作走快速决策层,异常、歧义、失败时再升级推理
七、浏览器 Agent 和企业内网系统特别适合
最近一直在看 Browser Agent,所以看到这套东西的时候,很自然就会往这块联想。
现在 Browser Agent 常见的一条执行链是:截图 / DOM → 大模型 → 理解页面 → 决定动作 → Playwright。如果每一次 click、type、scroll 都要过一遍完整推理,性能和成本都会比较明显,页面越复杂、步骤越多,问题越突出。
把两类动作拆开会更自然:正常页面操作走快速决策层,直接拿动作概率执行;只有碰到找不到目标、页面结构变化、多个动作概率接近、操作失败、登录态丢失、验证码这类情况,才切到深度推理,重新理解页面、调整计划。
对内部系统来说还有一个额外好处:很多页面流程本来就是高度固定的。菜单在哪、表单怎么填、提交按钮在哪、成功状态长什么样,本身就比较稳定。没必要每一步都重新「理解世界」。
八、它还能当 Agent 的 Judge
做 Agent 还有一个挺现实的问题:怎么判断任务到底做成功了没有?
给一个 Agent 下任务「打开系统,把订单 12345 的状态改成已取消」,它操作五六步之后告诉你「操作完成」。这句话并不能证明任务真的完成。所以现在做 Agent 测试,经常还需要一个 Judge:把用户目标 + 执行轨迹 + 最终页面交给另一个大模型,再判断任务有没有完成。
JEV-27B-VL 这种模型在这里刚好也能用。直接问「当前任务是否已经完成?」,得到 True 0.93 / False 0.07。项目方在 AgentRewardBench 上也做了这类实验,把它直接当 Agent Judge 用。
这让我比较感兴趣。因为如果以后这类模型成熟,Agent 测试的结构里可能会出现一个新组件:任务 → Agent 执行 → 最终环境状态 → Judge → 完成概率 → 测试结果。现在自动化测试主要靠明确断言,未来在一些很难用传统 Assert 描述的 AI 场景里,可能会同时存在两套判定机制——一套是确定性断言,一套是概率化的效果判断。
九、Benchmark 先放一边,我更想验证的是架构
JEV-27B-VL 的模型卡里确实有不少挺亮眼的数据,视觉推荐、Agent Judge、Computer Use、多模态判断都有覆盖。有些实验结果也挺夸张,比如只看用户最近看过的视频封面去判断会不会点,AUC 和基于几万用户行为训练出的协同过滤几乎打平。
不过这里还是要冷静一点。这个模型刚出来没多久,目前不少实验和 Benchmark 都来自项目方自己。它到底能不能在复杂生产环境里保持概率校准,换个业务场景之后稳不稳定,中文企业页面效果怎么样,长时间运行会不会出现决策漂移,System 1 的置信度阈值应该怎么定,什么时候该强制升级到 System 2,高并发下吞吐怎么样——这些问题其实都比排行榜名次更重要。
所以现在看它,我比较关注的还是结构。它提供了一种很明确的思路:Agent 没必要把每一步都做成一次完整推理,有些地方只需要一个稳定、快速、带置信度的判断。
过去这一两年,大模型主要在解决「能不能想明白」,于是大家一直在堆 Reasoning、CoT、Planning、Tool Use。真正开始做 Agent 之后,还会遇到另一个工程问题:哪些事情值得调用这些能力?一个成熟的软件系统里,正常路径最好足够简单、稳定、便宜,复杂模型更适合处理异常和不确定性。
Jev、Laya、JEV-27B-VL 这几类模型,都在补同一个位置:在传统程序逻辑和大模型深度推理之间,加一层概率决策。这一层既不像 if else 那么死,也不像完整 LLM 那么重。对 Agent 来说,这个位置其实一直存在,只是过去大家习惯直接拿大模型顶上去。
我接下来更想试的,反而不是单独跑几个 Benchmark,而是几个真实场景:浏览器下一步动作选择、MCP 工具路由、工具执行结果判定、任务是否已经完成,复杂情况再升级给大模型。如果这些能跑通,这类模型的价值就比较明确了。以后一个 Agent 的核心架构,可能不只有 Planner、Tool、Memory,中间还会多出一个很重要的东西:Decision Layer。
参考资料
AutoTrust, JEV-27B-VL: A Decision Model that Learned to See, Hugging Face 模型卡与项目博客,2026 年。
TypeSafe AI, Introducing System One Models and Jev, typesafe.ai。ConvAI Innovations, Laya, Hugging Face 模型卡。
本文涉及的 Computer Use 完成率、点击延迟、Agent Judge AUROC 等数据均来自项目方自述,尚未经过第三方大规模复现,引用时以「项目报告」标注,供架构参考,不作为选型结论。